ZhangYvJing's

Daily Brief

← October 22, 2026 October 23, 2026 · Friday October 24, 2026 →
00

Film / Book Chapter

First Man
2018 / Damien Chazelle

First Man (2018) · Damien Chazelle

今天适合看《First Man》,因为它更像一次生活和判断方式的校准,能把注意力从持续输入里稍微抽出来,重新放回你真正想怎样生活和做事上。

Working in Public
Nadia Eghbal

Working in Public · Nadia Eghbal

Chapter 3: The Structure of an Open Source Project

A sharp chapter for thinking about visible work, maintainer labor, contributor flows, and why software ecosystems are not just code repositories.

01

Insight

今天的材料揭示出 AI 代理能力正从“能做什么”转向“该怎么安全地做”,而技术自主权正在与区域监管发生夹杂。Quad9 在法国事件印证了 DNS 中立问题本就是噪声,因为真正的安全讨论不停angers 在代理对系统资源的控制层面——OpenShell 用内核插桩+形式化验证把“能动”变成“限动”,这与 Cloudflare 的 security-audit-skill 在六阶段工作流里做的那种“先侦察后下手”逻辑完全同频。YouTube 上的视频进一步佐证了这个趋势:Reducto 用视觉语言模型破解 PDF 这层文档墙,说明 frontier models 终将要住进医疗、法律等文档厚重的领域;但 Max Kanat-Alexander 和 Nicholas Arcolano 的观点则提醒我们,真正决定产出的是工程师本身,而非模型。当 Cursor 把流量从 GPT 转到 Grok 时,PR 合并率 barely moved,说明模型效能提升在团队实力、工作流固度上被稀释;这类数据在 arXiv 上的 Environment Duels 里也有原形——authoring 与 solving 竞争对手,最强解答者未必是最强创作者。这意味着今天的研究热度不能只盯模型参数,必须跟进部署控制、评估方法;反之,若只在实验室里训练新算法而忽视“如何让代理安全出门”,就会像 eMudhra 那样因 SSL/TLS 事件被迫退出商业化,最终将技术割裂化为纯函数调用。综上,今天应该把焦点从模型争元斗移回代理生命周期、从功能演进聚焦到治理框架——毕竟安全的边界不是代码的终点,而是监控、回滚与人类复核的起点。First Man (2018)。
03

Hacker News

01
Quad9 (DNS Resolver) to Exit France
Quad9将于11月24日停止向法国用户提供免费DNS解析服务。法国法院在beIN公司诉案中作出不利裁决,要求Quad9阻断多个域名的DNS解析,同时将每日罚款从58万欧元 reducing to 1,000 euros。Quad9坚持递归DNS解析应保持中立,不得因外部要求篡改DNS响应,而不保存用户身份信息或地理位置数据。该公司认为自全球实施DNS封锁会使法国司法指令产生跨国效应,违背互联网基本运作原理。 该决定意味着法国用户将失去兼顾隐私与网络安全的DNS解析选择,同时也暴露了司法机关对DNS技术运行机制的误解,可能对其他国家类似服务提供者产生连锁反应。
02
OpenShell 0.1.x 发布,作为 autonomous AI agents 的安全私有运行时,首次提供稳定的发布节奏、新的隔离原语、扩展的插件接口以及新增的API。该系统通过内核层插桩在文件访问、系统调用和网络连接上实时执行策略,同时借助形式化验证在策略变更获准前检测风险,从而让代理仅获授权访问数据、密钥和网络资源。开发者可通过声明的策略控制代理行为,并在升级指南中查看具体迁移步骤。此版本的安全模型和多平台支持,将影响 AI 代理在企业环境中的部署方式、合规成本及潜在安全暴露风险。
03
Arc is being sunset on December 22, 2026
Arc 浏览器将于2026年12月22日正式关闭服务,届时用户无法再登录或使用该工具。公司将在关闭日统一作废所有账户,30天后自动删除关联的个人数据。用户可通过少量操作将已设置的功能迁移至Dia,原有收藏和配置均未丢失。该决策意味着依赖Arc的用户将需提前规划工具切换,届时面临数据备份与工作流程调整的风险。
04
Getting ready to operate GNU Taler in Germany
连续三年研发的NGI Taler项目终于迈出实质一步,Taler Operations AG在德国博赫UM设立,计划首在德国启动欧元Taler支付业务。原定由GLS银行担任电子货币发行方后被迫撤回,促使项目组转型成立专注运营的公司,规避了传统银行业务嵌入的复杂合规与IT系统约束。此举意味着开发者与开源社区可继续推进系统安全审计及整合,配合项目获批后同步启动的投资者则需关注监管许可期间的资本准备与商业计划评估,最终决定资金方、合规方以及最终用户在隐私与支付自主性方面的决策路径。
05
Show HN项目展示了在Android设备上运行完整iOS 16.5固件的能力,该项目通过启动Apple开源的XNU内核(xnu-8796.121.2),在Android硬件上运行未修改的iOS 16.5用户空间组件。项目构建了自己的EFI加载器、UEFI端口以及对Apple闭源驱动的替代实现,同时利用Linux Wi-Fi驱动在兼容层上运行,实现从launchd到SpringBoard再到应用的完整启动链。该项目支持POCO X5 Pro 5G手机和QEMU虚拟机两种运行环境,所有iOS系统文件均从Apple官方CDN下载提取,且仓库中不包含任何Apple文件,仅作独立研究使用,与Apple Inc.无隶属关系。对于希望在Android硬件上进行iOS内核研究或进行跨平台系统移植的开发者而言,这提供了一个全新的技术路径,但也涉及显著的硬件要求和操作复杂性。
07
美国塔菲琳女士因他人诈骗在她名下开的Cash App账户被亚利桑那州起诉,面临最高六年监禁。警方在她家查nap warrants后将她遣 returned to Arkansas,其 bail set at $50,000,随后因账户涉嫁计算机欺诈和盗窃被追加$20,000 bail。诈骗通过黑客控制的Facebook Marketplace卖家账号诱导受害者转账, Cash App按其社会安全号和生日注册的假冒账户将款项分割后转出。账户驻留地址、通信运营商及设备系统版本均与被告AT&T服务及iOS 26.5.2产生矛盾, Cash App最初拒绝在她无法证明所有权时披露账户数据。此事凸显金融平台身份验证流程与执法取证标准之间的滞后风险,促使用户重新评估社交媒体交易中的个人信息防护与跨州追诉成本。
08
AI and the Enclosure of the Scientific Commons
AI正在通过自动化工具对科学文献进行“圈占”——将原本由全球科研界共享的文献资源转化为私有财富。文章将科学文献比作“信息公地”,指出传统农业公地在 Enclosure Movement(圈地运动)中被依法私有化,而信息公地却因AI技术得以被重新包装为可商业化的资产,关键机制是AI聚合大量论文数据制造“垃圾信息”效应,削弱社区对共享资源的维护。科研工作者需面对文献获取成本上升、工具依赖风险以及学术共建体系的潜在崩溃。
09
十二款AI语言模型被要求给出最具争议的人类观点,其中29个回答中突显相同核心:人类更依赖从属感而非真理,7型模型甚至全数得到相同结论。研究说明文本模型通过训练数据学习到对人类行为的普遍批判,而绘图模型则呈现不同焦点,如手机成瘾或身体形态,但十几率集中于“人类消费主义自毁”主题。这种统一输出可能让内容审核、伦理设计及人机交互团队面临模型一致性风险,需重新评估系统输出的可预测性与差异化需求。
10
eMudhra计划退出全球SSL/TLS证书业务,聚焦于核心企业解决方案和除SSL/TLS外的信任服务。该决策源于近期涉及SSL/TLS证书的事件,公司在发现后14小时内撤销受影响的证书颁发机构,并及时披露信息。虽然事件未导致数据泄露或基础设施受损,但由于SSL/TLS业务仅占全球收入约1%,且随着数据主权与合规要求日益复杂,业务成本上升,且大量企业免费提供SSL/TLS证书,使该业务的商业潜力和投入产出比显著下降。社交媒体对事件的放大引发超预期的关注,董事会认为退出是为股东和公司最佳决定。
04

GitHub Trending

Daily · Top 10

01
cloudflare/security-audit-skill
Cloudflare发布的security-audit-skill是一套面向AI编码代理的安全审计工具,通过六阶段工作流实现系统性漏洞挖掘。该工具先进行侦察阶段梳理架构与输入表面,然后基于覆盖率追踪进行 hunters 野查,随后交叉验证可疑候选人,输出结构化JSON审计结果,并经独立代理复核后生成中性报告。它支持HTTP协议、内存安全、供应链、云部署等13大攻击类别,适用于需要多回合、可追溯的源码安全评估场景。
02
vllm-project/vllm
vLLM是一个高吞吐、内存高效的大语言模型推理与推理引擎,由UC伯克利-sky计算实验室最初开发,现由2000多位来自数百所学术机构和公司的贡献者维护。它通过PagedAttention高效管理注意力键值内存,实现连续批处理、块化预填充和前缀缓存,支持FP8、INT4等多种量化技术,集成FlashAttention、TRTLLM等优化内核,并内置n-gram、EAGLE等推测解码器。vLLM支持200多种Hugging Face模型架构,覆盖解码器型LLM、Mixture-of-Expert模型、状态空间模型和多模态模型,提供OpenAI兼容API服务器和分布式推理支持,适用于需要高性能LLM推理服务的场景。
03
stablyai/orca
Orca 是一个 AI 任务编排器,允许用户同时运行多个代码代理(如 Claude Code、Codex、Grok Bot 等),每个代理在独立的 Git worktree 中工作,结果集中管理。它支持桌面端、移动端和远程运行环境,提供平行工作目录、网页端原生浏览 GitHub PR 和 Linear Issue、终端分屏、设计模式可视化点击采集 UI 元素、AI 代码 Diff 注释、文件拖拽至代理、CLI 脚本化工作流等功能。适合需要并行调研多模型输出、跨平台监控智能体任务、或在远程高性能机器上协调开发工作流的开发者使用。
04
headroomlabs-ai/headroom
Headroom 是一个本地运行的压缩工具,针对 AI 编码代理的输入内容进行处理。它支持压缩工具输出、日志、文件、RAG块以及对话历史,针对 JSON 数据可实现 60% 至 95% 的 token 减少,编码场景约 20% 减少,同时保持相同回答效果。采用 Library、Proxy、MCP Server 三种部署方式,支持 Claude、Copilot、Codex 等主流 coding agent,compression 流程包含 SmartCrusher、CodeCompressor 与 Kompress-v2-base 三大组件,并具备可逆 CCR 缓存与 cross-agent memory 功能。适用于希望降低 LLM 调用成本、加速响应的开发工作流,其运算开销极低,典型场景包括 SRE 故障排查、GitHub Issue 初筛及大规模代码库探索。
05
DietrichGebert/ponytail
Ponytail 是一个让 AI 代码代理像懒散资深开发者一样工作的工具,核心理念是“最好的代码是不写的”,通过内置到 Claude Code、Codex 等代理中实现。它不只是删除重复代码,更全面审查代码时的 bug、安全风险、测试覆盖、性能和可访问性,确保削减不削弱。版本 5 rebuid后,实现-53%代码量、-41%耗时、-45% token消耗,同时将风险逻辑的测试通过率从68%提升到98%。它适用于需要高效、可靠交付的前端和后端项目,尤其擅长在已有组件(如输入框)与浏览器原生功能(如日期选择器)之间寻找最小化解决方案。
06
Comfy-Org/ComfyUI
ComfyUI 是一个基于 Python 开发的模块化扩散模型图形界面工具,采用节点图接口实现图像、视频、3D、音频等多模态内容 creation。其核心能力在于通过异步权重流技术支持低配hardware(4GB VRAM + 8GB RAM)运行大型开源模型,并内置丰富的图像生成、编辑、视频与音频合成等 workflow 模板。该项目跨 Windows、Linux、macOS 平台,提供本地部署、便携式及云服务三种模式,同时支持接入闭源模型节点,如适用于视觉专业人士及 AI 创作者对 model、parameter 全链路控制的场景。
07
supabase/supabase
Supabase 是基于 PostgreSQL 构建的开发平台,为 Web、移动和 AI 应用提供托管数据库服务。它通过组合多个开源工具实现 Firebase 类似功能,核心能力包括自动生成的 REST 和 GraphQL API、实时订阅、身份认证、文件存储以及向量嵌入工具。架构上包含 PostgREST、Realtime、GoTrue、Storage 等组件,支持本地自托管或云端托管。适用场景涵盖需要快速搭建后端、用户认证、实时数据同步及文件管理的开发项目,尤其适合追求开源解耦方案的团队。
08
twentyhq/twenty
Twenty是用TypeScript开发的开源CRM系统,定位是Salesforce的替代方案。它为技术团队提供构建自定义CRM的模块,支持通过代码定义对象、字段和视图。采用Nx、NestJS、PostgreSQL等技术栈构建,前端使用React框架。用户可通过官方CLI工具快速创建应用:npx create-twenty-app my-app。其核心能力在于以代码方式管理CRM配置,支持版本控制。部署方式灵活,既可通过云服务(twenty.com)快速启动,也可使用Docker Compose进行自托管。适合需要高度定制CRM功能的技术团队,尤其适用于业务复杂且需求频繁变更的场景。
09
shiyu-coder/Kronos
Kronos 是首个针对金融市场K线(蜡烛图)数据设计的开源基础模型,由Python实现,已通过AAAI 2026论文认证。该模型专为处理金融数据的高噪声特性而构建,采用两阶段框架:首先通过专用tokenizer将连续的多维K线数据(OHLCV)量化为分层离散token,然后使用大型自回归Transformer进行预训练。模型支持从mini到large多个规格,最大上下文长度为2048(mini型)或512(其他型号),可在Hugging Face Hub获取。其核心能力在于对多时间序列金融数据的统一建模,用户可通过KronosPredictor类进行简便调用,支持单序列预测、批量预测及微调,适用于加密货币如BTC/USDT的24小时价格预测、全球45多个交易所的数据分析,以及中国A股市场的数据处理等量化金融任务。
10
strelov1/freehire
免费求职引擎(freehire)是基于 Go 语言开发的开源搜索平台,专为找工作人群设计。它通过爬取 330 万条来自 47 万家公司 124 个ATS平台(如Workday、Greenhouse)的直连职位信息,构建真实、未被重复的求职数据集。平台支持面向职位地点、工作模式、职称、技能等维度的分面检索,并提供完整的求职工具链,包括简历生成、投递跟踪、AI匹配分析及Telegram邮件摘要。同时,系统开放API接口和自托管架构,适用于个人求职者、招聘机构或开发者构建定制化求职助手。
05

YouTube

01
AI agents can reason over enormous amounts of information, but much of the world’s actual work is still trapped in PDFs, spreadsheets, scans, and other formats that models struggle to reliably understand. Reducto co-founder and CEO Adit Abraham argues that solving this document layer is essential if agents are going to take on consequential work in healthcare, legal, finance, and insurance. Adit joins a16z General Partner Jennifer Li to explain why traditional OCR breaks down on messy real-world documents, how Reducto combines vision-language models with specialized infrastructure to reach hi
agent, ai_frontier, ai_product, market, security, startup
02
Every senior engineer's answer is "it depends." Max Kanat-Alexander says what it actually depends on. Code quality always existed for two things: understanding a system and safely changing it. AI is making a new kind of software common: disposable software, with low consequences, few dependents and near-zero cost to replace or maintain. For that software, quality doesn't matter. For durable software it matters more than ever. He also shows how to make systems more disposable and how to make rigor cheap through standards, in-workflow tooling, easy testing and maximum strictness. Chapters: - 00
agent, ai_product, engineering
03
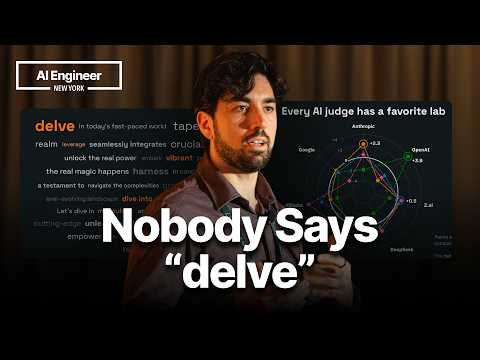
Louis-François Bouchard of Towards AI breaks down what makes AI writing feel like slop: overused words, vague generalities, saying nothing, repetition, hallucination and a voice that sounds like everyone at once. He then shows how his team built a benchmark to measure whether a model can write a video script in his own voice: 10 scripts, 5 drafts per model, 4 LLM judges, nine scoring metrics and 1,000 human A/B checks. He shares what it cost, why judges favor their own model family, and practical tips for writing with AI: very long prompts full of examples, one review pass from a strong model,
agent, ai_frontier, ai_product, engineering
04
Nathanael Weill leads a team building AI agents at Air Canada, where tasks are so specific there's no public benchmark and domain experts have little time to grade results. His fix is to write the answer first: start from a known answer, generate the input from it, and check whether the agent finds its way back. He shows how that took a past RAG project from one expert-graded test a week to dozens of automated tests a day, then applies it to a supplier-contract review agent with five ways to build a test set: past decisions, planted rule violations, removed clauses, changes that shouldn't matt
agent, ai_frontier, ai_product, engineering
05
Vishal Srivastava and Tanmay Sah studied 1,368 incidents from a public AI incident database to ask what real failures say about how AI systems should be tested. They sort failures across three areas (technical strength, deployment controls and business impact) and 13 sub-areas that cover about 98% of incidents. Weak deployment controls, such as human review and monitoring, are the most closely tied to harm. They show how to rank use cases by how much is at stake, why the evaluator itself needs checking, and a build-break-fix loop that tries to prove a system wrong instead of right, applied to
agent, ai_product, engineering
08
Nicholas Arcolano, head of AI and research at Jellyfish, uses data from about 50,000 engineers at 447 companies to ask how much the model really matters for AI coding output. When Cursor pushed many of its users onto Grok, merged PRs barely moved. Breaking down what drives throughput, the tool explains under 1%, skill use about 3% (heavy skill users see roughly a 30% bump), token usage about 9%, company and team about 12%, and the individual engineer most of the rest. The engineers who were top performers before AI are mostly still the top performers now. His advice for leaders: focus on the p
agent, ai_frontier, ai_product, engineering
09
AI Trade School for Healthcare
Stepful (YC S21) trains people for healthcare jobs, combining AI-supported learning with local hands-on training. The company trained 30,000 people last year and now works with 39 health systems, including seven of the 10 largest in the U.S. It recently raised a $55 million Series C led by Oak HC/FT. In this episode of Founder Firesides, YC Managing Partner Diana Hu hosts co-founders Carl Madi and Tressia Hobeika where they share how cleaners losing their jobs during the pandemic sparked the idea for a faster, more affordable path into healthcare. They discuss preparing students for medical a
ai_frontier, ai_product, market, product, startup
10
What would you get if Bloomberg, Claude, and Netflix had a baby? Moshi founder and CEO Anekha Sokhal joins swyx at AI Engineer NYC to discuss building AI tools for traders: connecting market data, handling conflicting sources, and turning insights into recommendations people actually use. They also discuss the pressure on AI engineers to become the whole team, and how to make the most of conference conversations. Moshi: https://hellomoshi.ai/ AI Engineer: https://ai.engineer/ Latent Space: https://www.latent.space/ Chapters: 00:00 AI Engineer NYC and the one-person team 00:54 Meet Anekha So
agent, ai_frontier, ai_product, engineering, market, startup
11
AI workloads don’t run in neat, three-year rectangles. But much of the GPU market still sells capacity that way. Modal CEO Erik Bernhardsson joins Latent Space to explain how Modal pools compute, scales AI workloads and thinks about the financial risks of building a GPU cloud. Erik takes us from building Spotify’s recommendation system to founding Modal, then digs into GPU supply, alternative accelerators and the surprising growth of agent sandboxes. We also discuss sandbox security, developer experience in the age of agents, forward-deployed engineers and why Modal makes code review optional
agent, ai_frontier, ai_product, engineering, market, security, startup
08

Papers